NVIDIA DGX Spark 64GB 发布:桌面级 AI 超算再破局
⭐ **NVIDIA 发布 DGX Spark 64GB**(2026-10-02,**4999 美元**,10-23 发售)。⭐ **统一内存架构**(CPU + GPU 共享 64GB 高带宽内存池,**预留 8GB 系统,可用 56GB**)—— ⭐ **27B / 35B 经典模型"黄金配置"**。⭐ **NVFP4 量化 + KV Cache 优化 + 投机解码** —— Perplexity llama.cpp/vLLM 优化后速度 **最高 1.9×**。
一句话总结
⭐ NVIDIA 发布 DGX Spark 64GB(2026-10-02,⭐ 4999 美元,10-23 发售)。⭐ 统一内存架构(⭐ CPU + GPU 共享 64GB 高带宽内存池**,⭐ 预留 8GB 系统,可用 56GB)—— ⭐ 27B / 35B 经典模型”黄金配置”。⭐ NVFP4 量化 + KV Cache 优化 + 投机解码 —— Perplexity llama.cpp/vLLM 优化后速度 ⭐ 最高 1.9×。⭐ Artificial Analysis v4.3:本地 Qwen3.8 27B 34 分 ≈ 云端 Flash 梯队(GLM-4.3-Flash 42 / Qwen3.8-Flash-Next 40)。⭐ 2 台集群 1.7× 吞吐。⭐ 六大 OEM(宏碁 / 华硕 / 戴尔 / 技嘉 / 惠普 / 微星)同步便携版。⭐ Day-0 模型:Qwen3.8 27B / LTX 2.5 / Meta Muse Glimmer / Gemma 4 / Poolside Laguna S 2.1 / Inkling-Small。
一、市场背景 ⭐
AI 智能体爆发
”⭐ 根据 2026 年 5 月初的顶级开源模型数据快照,⭐ AI 智能体在 GitHub 上的星标数自 2012 年以来呈现出惊人的指数级增长,⭐ 相关项目如 Linux / PyTorch / Hermes 和 OpenClaw 等热度持续攀升,从最初的 100k 飙升至 373k。”
⭐ OpenRouter Agent 主导
| 指标 | 数据 |
|---|---|
| ⭐ Token 用量 | ⭐ 80% 由 Agent 贡献 |
| ⭐ Top 50 App | ⭐ Agent 月 Token 消耗 27 万亿次 |
| 对比:其他 AI 应用 | 6 万亿次 |
痛点 ⭐
”⭐ 传统的 PC 架构在面对高频、长上下文的交互时,往往因为显存容量不足或内存带宽瓶颈而捉襟见肘。⭐ DGX Spark 将完整的 CUDA 加速 AI 软件栈下放至桌面,意味着开发者不再需要为了运行一个智能体而去排队等待云端 GPU 实例。”
二、DGX Spark 64GB 关键参数 ⭐
规格 ⭐
| 维度 | 详情 |
|---|---|
| ⭐ 统一内存 | ⭐ CPU + GPU 共享 64GB 高带宽内存池 |
| ⭐ 系统预留 | ⭐ ~8GB(OS + 基础服务) |
| ⭐ 可用空间 | ⭐ ~56GB(用户可用 KV Cache 余量) |
| ⭐ 价格 | ⭐ $4,999 美元 |
| ⭐ 发售 | ⭐ 2026-10-23 |
⭐ 架构优势
”⭐ 革命性的统一内存架构,⭐ 在这种架构下,CPU 与 GPU 共享同一块 64GB 的高带宽内存池,彻底消除了传统 PC 中数据在显存与内存间拷贝的 PCIe 带宽瓶颈。”
”⭐ 56GB 的可用空间对于运行 27B 至 35B 级别的模型来说堪称”黄金配置”,⭐ 它彻底解放了长文本和多模态推理的枷锁。”
三、模型兼容性 ⭐
| 模型 | 架构 | 权重占用 | 剩余 KV Cache |
|---|---|---|---|
| ⭐ Gemma 4 26B-A4B | ⭐ MoE(4B 活跃) | 15 GB | ⭐ 41 GB |
| ⭐ Qwen3.8 27B | ⭐ Dense | 16.5 GB | ⭐ 40 GB |
| ⭐ Gemma 4 31B | Dense | 18 GB | 38 GB |
| ⭐ Qwen3.6 35B-A3B | ⭐ MoE(3B 活跃) | 21 GB | ⭐ 35 GB |
| ⭐ Meta Muse Glimmer (30B dense, 多模态) | ⭐ 多模态 | 17 GB | ⭐ 39 GB |
| ⭐ Nemotron 3.5 Lightning (30B-A3B MoE) | MoE | 17 GB | 39 GB |
”⭐ 多模态模型在处理图像、视频等非文本输入时,会产生巨大的 KV Cache 开销,DGX Spark 的统一内存架构使其在桌面端运行多模态 Agent 成为可能。”
四、性能优化 ⭐
三项关键技术 ⭐
| # | 技术 | 效果 |
|---|---|---|
| ⭐ 1 | ⭐ NVFP4 量化 | ⭐ 桌面端硬件特性算子级深度定制 |
| ⭐ 2 | ⭐ KV Cache 效率提升 | ⭐ 优化注意力内存访问 + 显著降低冗余 |
| ⭐ 3 | ⭐ 投机解码 | ⭐ 不损失精度 + 大幅提升生成速度 |
⭐ Perplexity 优化 ⭐
”⭐ 在 AI 搜索引擎公司 Perplexity 针对 llama.cpp / vLLM 等的深度优化下,⭐ 如今本地智能体在 DGX Spark 上的运行速度,相比 DGX Spark 在 Computex 被正式宣布纳入个人超算产品线发布时,最高可以提升 1.9 倍。”
五、Artificial Analysis Intelligence Index v4.3 测评 ⭐
| 模型 | 评分 | 部署 |
|---|---|---|
| ⭐ Claude Fable 5.1 (Max With Fallback) | ⭐ 53 分 | ⭐ 领跑 |
| ⭐ Claude Opus 5 (Max) | ⭐ 51 分 | 云端 |
| GLM-4.3-Flash | ⭐ 42 分 | ⭐ 云端 Flash |
| Qwen3.8-Flash-Next | ⭐ 40 分 | ⭐ 云端 Flash |
| ⭐ Qwen3.8 27B (x High) | ⭐ 34 分 | ⭐ 本地 DGX Spark 64GB |
”⭐ 本地部署的 Qwen3.8 27B (x High) 取得了 34 分的成绩,与 GLM-4.3-Flash (42 分) / Qwen3.8-Flash-Next (40 分) 等云端轻量级模型差距在 10 分以内,基本处于同一竞争梯队。”
”⭐ 开发者在桌面上即可获得媲美云端主流 Flash 模型的智能体验,且完全掌握数据主权。”
六、集群扩展 ⭐
2 台 DGX Spark 64GB ⭐
| 测试 | 性能 |
|---|---|
| ⭐ AIPerf SPEED-Bench | ⭐ **2 台 64GB 集群 Overall Throughput (Tok/s) 最高 1.7× |
⭐ NVIDIA Sync 工具 ⭐
”⭐ NVIDIA Sync 工具,⭐ 不仅支持远程连接 DGX Spark 以检查系统状态,还能无缝对接 Cursor / VS Code 和 AI Workbench 等主流开发环境。”
“从单机到多集群的平滑拓展路径,⭐ 完美契合了开发者从原型验证到规模化部署的全生命周期需求。
⭐ ConnectX-7 集群 ⭐
”⭐ ConnectX-7 网络无缝集群化,是 NVIDIA 专业消费级市场的一次「降维打击」。过去,组建小型 AI 集群需要极高的网络配置门槛和昂贵的交换机设备,而 NVIDIA Sync 和 Cluster Assistant 将这一过程简化到了「傻瓜式」的一键操作。”
七、价格 + OEM 生态 ⭐
价格 ⭐
| 维度 | 详情 |
|---|---|
| ⭐ 起售价 | ⭐ $4,999 美元 |
| 发售日 | 2026-10-23 |
| 定位 | ⭐ 黄金配置,性价比极高 |
⭐ 六大 OEM 厂商 ⭐
”⭐ 宏碁 / 华硕 / 戴尔 / 技嘉 / 惠普 / 微星 等 OEM 厂商同步推出的便携版本。”
”⭐ 六大 OEM 厂商的集体站台,意味着 DGX Spark 不再是一个极客专属的「玩具」,而是即将进入主流供应链的标准化产品。”
八、Day-0 支持模型 ⭐
”⭐ 首发即支持的模型:⭐ Qwen3.8 27B / LTX 2.5 / Meta’s Muse Glimmer / Gemma 4 / Poolside AI Laguna S 2.1 以及 Thinking Machine Lab’s Inkling-Small。”
模型清单 ⭐
| 模型 | 厂商 |
|---|---|
| Qwen3.8 27B | 阿里 |
| LTX 2.5 | — |
| Meta Muse Glimmer | Meta |
| Gemma 4 | |
| Poolside AI Laguna S 2.1 | Poolside AI |
| Inkling-Small | ⭐ Thinking Machine Lab(Mira Murati) |
九、行业意义 ⭐
“DGX Spark 64GB 的发布具有极强的风向标意义。过去,高性能 AI 计算往往被绑定在昂贵的数据中心或庞大的工作站中,而 NVIDIA 此次将「⭐ AI 超级计算机」的概念⭐ 直接浓缩至桌面级设备,⭐ 彻底改变了 PC 硬件的演进逻辑。”
”⭐ 这不是一台高性能主机的更新,而是宣告了「AI 原生 PC」时代的到来。”
”⭐ 桌面算力不再仅仅以传统的 FLOPS(浮点运算次数)来衡量,⭐ 而是转向了以 AI 推理吞吐 / 统一内存带宽和智能体并发能力为核心的新评价体系。”
”⭐ NVIDIA 正以 DGX Spark 为支点,撬动一个去中心化、隐私优先、普惠共享的 AI 计算新时代。”
配图
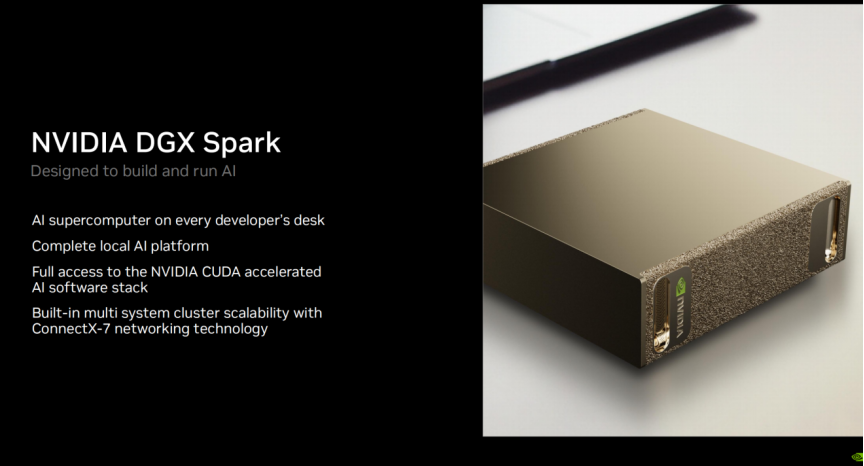
图 1:NVIDIA DGX Spark 64GB —— 统一内存架构 + $4,999 + 27B-35B 黄金配置(微型计算机 · 2026-10-02)
来源
- 网易新闻(微型计算机)· 原文
- NVIDIA DGX Spark Update 会议(2026-10-02)
- Perplexity(llama.cpp / vLLM 优化)
- Artificial Analysis Intelligence Index v4.3
- AIPerf SPEED-Bench
- 六大 OEM 厂商(宏碁 / 华硕 / 戴尔 / 技嘉 / 惠普 / 微星)